- 10 minutos
- nov 5, 2026
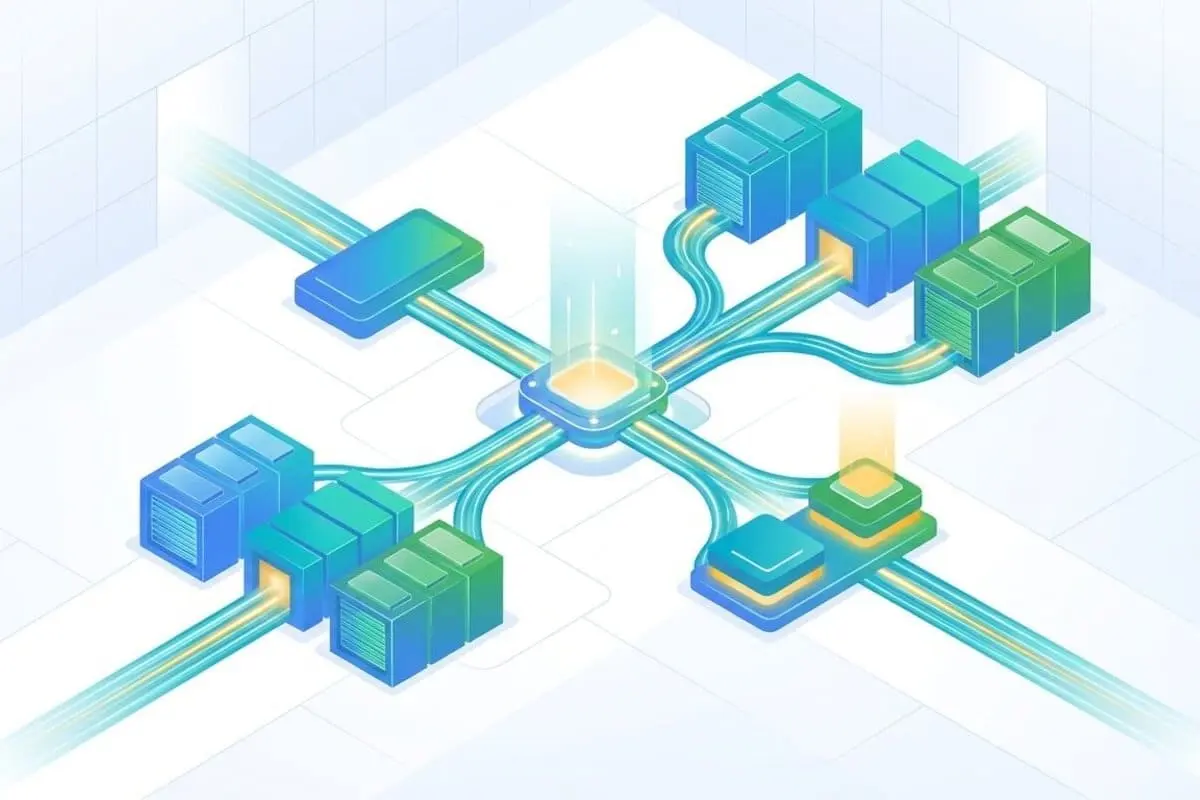
Treinar modelos de linguagem e colocar esses sistemas em produção costuma gerar custos altos quando a infraestrutura cresce. Coordenar milhares de chips em servidores separados gera filas de espera e quebras frequentes de processamento. O Cloud Pathways resolve essa trava ao substituir o controle fragmentado por uma arquitetura de controlador único.
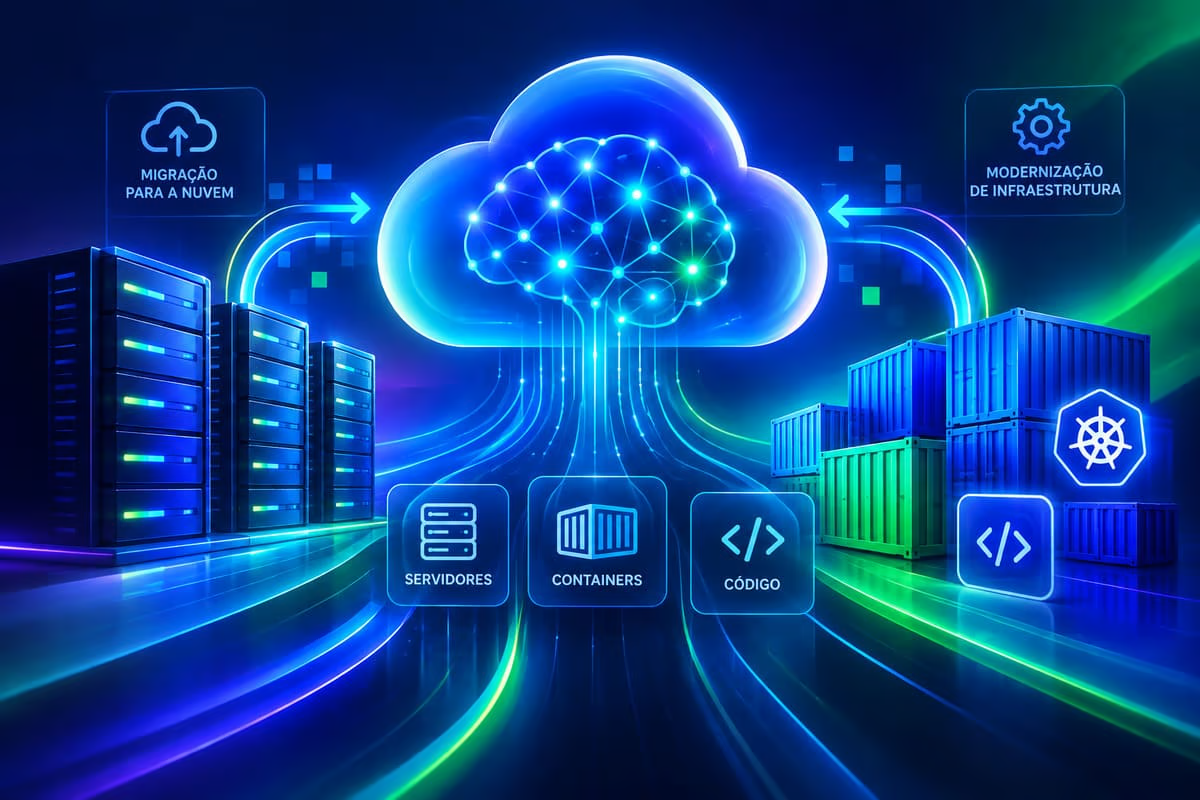
Criado pelo Google DeepMind para treinar modelos como o Gemini, o sistema opera integrado à camada do AI Hypercomputer. Um cliente central organiza o trabalho de toda a frota de aceleradores como se fosse um único computador local. A tecnologia já processou mais de 130 milhões de chip-horas de TPU em produção em um período de três meses no Google Kubernetes Engine.
Neste guia, você vai entender como essa arquitetura funciona na prática e o que muda na separação de tarefas de inferência. Você também verá como configurar o ambiente no Google Kubernetes Engine ou no Cluster Director para proteger o orçamento do seu projeto.
O Cloud Pathways é um ambiente de execução (runtime) distribuído para machine learning concebido pelo Google DeepMind. Ele foi criado para acelerar modelos de ponta, como o Gemini, e agora faz parte do AI Hypercomputer no Google Cloud. O sistema elimina o limite do modelo tradicional SPMD (Single Program, Multiple Data), no qual cada máquina executa uma cópia idêntica do código com visão restrita.
Para superar essa barreira, o runtime adota um cliente central baseado no Interim Framework Runtime (IFRT). Essa camada de software faz com que o cliente enxergue milhares de aceleradores espalhados pelo cluster como se fossem uma única máquina local. Isso remove a necessidade de programar a sincronização manual entre cada placa.
No modelo padrão do framework JAX, cada servidor executa um processo Python isolado. Esses processos possuem apenas uma visão localizada dos aceleradores conectados ao próprio chassi. Quando um job cresce para centenas de máquinas, qualquer desalinhamento entre esses processos paralelos paralisa o trabalho.
Com o Cloud Pathways, você centraliza a lógica do programa em um grafo computacional único, que funciona como um mapa completo das operações. O cliente despacha as tarefas de forma assíncrona usando instruções compiladas em XLA HLO (a representação intermediária do compilador de aceleração). Além disso, o sistema utiliza o Cloud Storage como cache persistente de compilação.
O armazenamento guarda os binários e grafos já compilados, evitando que novos nós ou execuções percam tempo recompilando o código do zero.
A fase de inferência — quando o modelo responde aos usuários — envolve duas etapas com exigências de hardware bem distintas: o prefill e o decode. O prefill processa todo o texto de entrada de uma vez em grandes lotes paralelos, demandando alto volume de cálculo numérico. Já a etapa de decode gera cada nova palavra de forma sequencial, sendo limitada pela largura de banda de memória para ler pesos e o cache de contexto a cada token.
O Cloud Pathways viabiliza a inferência desagregada, separando essas duas etapas em nós aceleradores diferentes e especializados. Em testes com o modelo Llama2-70B em chips Trillium (TPU v6e), essa divisão multi-host trouxe resultados expressivos:
Paradas não programadas em clusters de inteligência artificial custam caro. Para evitar que a falha de um único chip interrompa o treinamento de dias, o Cloud Pathways utiliza contêineres sidecar em Python. Esses contêineres atuam como processos auxiliares que compartilham memória diretamente nos servidores com aceleradores.
Quando ocorre um defeito físico, o sistema aciona um mecanismo de snapshotting de memória (um registro instantâneo do estado das variáveis). O runtime redimensiona o treino para N-1 slices de forma automática, isolando a fatia com defeito sem derrubar o cliente central. A equipe não perde o progresso da rodada e a infraestrutura continua produtiva.
Você pode adotar o Cloud Pathways por dois caminhos oficiais no Google Cloud. O runtime está em disponibilidade geral no Google Kubernetes Engine (GKE) e em versão prévia no Cluster Director para ambientes com Slurm. A escolha depende do modelo de orquestração que o seu time já opera no dia a dia.
Para iniciar a configuração, complete estes três passos técnicos:
A configuração de clusters no GKE acontece pela gcloud CLI ou por meio do Cluster Toolkit (gcluster). O Cluster Toolkit automatiza a criação do ambiente com modelos de infraestrutura prontos para inteligência artificial.
Essa abordagem permite provisionar diferentes famílias de aceleradores:
Com essas opções no GKE, o time escala nós aceleradores mantendo os mesmos padrões de governança de contêineres. Isso simplifica a gestão da infraestrutura sem criar silos operacionais.
A integração em versão prévia no Cluster Director estende o Cloud Pathways para o Slurm, o agendador padrão de supercomputação. Essa opção beneficia equipes de pesquisa que já possuem rotinas consolidadas em scripts de agendamento em lote.
O ambiente unifica a execução multi-slice, conectando vários blocos de chips sem demandar mudanças na estrutura do seu código. Os pesquisadores também podem conectar notebooks interativos diretamente aos nós alocados pelo Slurm para conduzir testes rápidos.
O Cloud Pathways oferece dois modelos de uso: sessões interativas de análise e execução em lote compartilhado. No modo interativo, engenheiros de machine learning conectam notebooks Jupyter ou terminais diretamente ao cluster. Essa conexão direta permite inspecionar tensores e depurar erros em tempo real, sem esperar em filas demoradas de agendamento.
Já em escala de produção, o Shared Pathways Service coordena um conjunto comum de aceleradores entre múltiplos usuários e cargas de trabalho. O compartilhamento dinâmico de hardware evita que fatias caras de processadores fiquem sem uso, reduzindo o custo operacional do projeto.
O Cloud Pathways acompanha diretamente a evolução física dos processadores no Google Cloud. O runtime já opera em disponibilidade geral em gerações consolidadas como TPU v5e, TPU v5p, Trillium (TPU v6e) e Ironwood (TPU 7x). Essa base contínua prepara o terreno para a oitava geração de TPUs, projetada para suprir as exigências da era agêntica.
A nova geração divide a arquitetura em dois motores complementares de hardware:
A união do framework JAX com o Cloud Pathways supera os limites de escalabilidade tradicionais. Essa combinação viabiliza coordenar o treinamento distribuído de modelos em mais de 1 milhão de chips simultâneos. Para a sua gestão, isso garante capacidade de expansão contínua sem necessidade de paralisar o trabalho para refatorar código.
Agentes corporativos realizam tarefas bem mais complexas do que um chatbot tradicional: eles planejam ações, consultam ferramentas externas e avaliam os próprios passos. O Cloud Pathways sustenta essas operações ao suportar fluxos heterogêneos e laços de aprendizagem por reforço (RL) dentro da mesma malha de computação.
Na aprendizagem por reforço — método em que o modelo aprende tomando decisões e recebendo recompensas —, a carga de trabalho varia a cada segundo. Em arquiteturas antigas, o cluster sofria com esperas ociosas enquanto alternava entre gerar alternativas e atualizar os pesos matemáticos do modelo. O Pathways sobrepõe essas etapas no mesmo ambiente, mantendo os aceleradores sempre ocupados.
Para eliminar o atraso na comunicação entre diferentes nós, o runtime trabalha em conjunto com o TPU Sync. Esse componente realiza a transferência direta de pesos e do cache KV (a memória de curto prazo que guarda o contexto da conversa) entre os aceleradores.
Ao mover dados diretamente entre os chips, o TPU Sync evita paradas nos pipelines multiagente. Na prática, isso garante respostas mais rápidas para os fluxos de trabalho da sua empresa e evita o desperdício financeiro de hardware ocioso esperando dados pela rede.
O Cloud Pathways funciona como uma peça central na pilha do AI Hypercomputer, a arquitetura integrada do Google Cloud que une hardware, compiladores e ferramentas de software. O runtime atua na camada intermediária, conectando a capacidade física dos aceleradores a bibliotecas de código aberto como o MaxText e a frameworks consolidados como JAX e PyTorch.
Com o MaxText — a biblioteca de referência de código aberto do Google para grandes modelos de linguagem —, você treina arquiteturas modernas sem reescrever rotinas manuais de paralelismo. O Pathways gerencia os recursos por baixo dos panos, direcionando os cálculos para onde houver capacidade computacional disponível.
A diferença prática entre o modelo tradicional e o novo padrão de execução fica evidente na tabela a seguir:
| Critério | Modelo SPMD multicontrolador tradicional | Modelo Cloud Pathways de controlador único |
|---|---|---|
| Visão do cluster | Fragmentada, com processos Python locais que enxergam apenas os aceleradores do próprio chassi. | Centralizada, com um único cliente orquestrador que enxerga toda a frota de chips via IFRT. |
| Tolerância a falhas | Rígida, paralisando o treino inteiro quando uma máquina ou chip apresenta defeito físico. | Elástica, redimensionando o job para N-1 fatias com sidecars e snapshotting sem derrubar a sessão. |
| Despacho de tarefas | Síncrono e em passos engessados, travando o lote se um único nó atrasar o processamento. | Assíncrono com compilador XLA HLO, liberando o cliente para despachar tarefas contínuas. |
| Inferência de LLMs | Acoplada, disputando os mesmos aceleradores para as etapas de prefill e decode. | Desagregada, dividindo nós focados em volume de cálculo e nós focados em largura de banda de memória. |
Essa evolução técnica apoia diretamente a prática de FinOps, a cultura operacional que une engenharia e finanças para extrair o máximo valor de cada real investido em nuvem. Ao manter fatias de hardware caras em uso contínuo e contornar falhas sem perder dias de processamento, a infraestrutura gera economia real e previsibilidade para o projeto.
A transição para modelos em larga escala pede uma base bem desenhada antes de ligar milhares de aceleradores. Avalie primeiro se a sua operação sofre com paradas durante o treinamento ou com lentidão na etapa de decode da inferência. O Cloud Pathways entrega a tecnologia para unificar o controle físico. Contudo, o retorno financeiro depende de configurar o ambiente sob as boas práticas recomendadas para o Google Cloud.
Operar aceleradores sem a preparação adequada faz a empresa gastar recursos desnecessários na nuvem. A SantoDigital apoia essa jornada por meio de equipes multidisciplinares, unindo especialistas de infraestrutura e inteligência artificial para estruturar a base técnica correta. Esse trabalho conjunto ajusta o ambiente para que as cargas de trabalho rodem sem impedimentos técnicos ou desperdício de capacidade.
Além da implantação, os serviços gerenciados de MLOps e Cloud Ops da SantoDigital atuam como um braço técnico contínuo para a sua equipe. Por meio de acompanhamento proativo, os especialistas revisam a governança do cluster, evitam a subutilização de hardware e garantem a eficiência financeira da operação.
Converse com os especialistas da SantoDigital para desenhar, otimizar e escalar seus clusters de inteligência artificial no Google Cloud.
A conexão GCP é a ponte de rede segura que liga a infraestrutura local da sua empresa ou de outras redes ao ecossistema do Google Cloud Platform. Essa integração pode ser feita por meio de túneis de VPN criptografados ou serviços dedicados de conectividade híbrida, garantindo que suas aplicações acessem bancos de dados e serviços em nuvem com baixa latência e proteção de tráfego.
O Kubernetes agrupa contêineres em unidades lógicas de trabalho chamadas pods, distribuindo-os entre vários servidores (nós do cluster). Um plano de controle (control plane) monitora continuamente a integridade dessas máquinas; se um servidor falhar ou a demanda subir, o sistema redistribui ou replica os pods automaticamente para manter a aplicação no ar.
O GKE (Google Kubernetes Engine) é o serviço gerenciado de Kubernetes do Google Cloud. Em vez de a sua equipe gastar horas configurando servidores e aplicando atualizações de segurança manualmente, o GKE automatiza a infraestrutura subjacente e oferece integração nativa com redes de alto desempenho e aceleradores de inteligência artificial.
A inferência é a etapa operacional em que um modelo de inteligência artificial já treinado entra em produção para responder a requisições reais de usuários e gerar previsões. Em grandes modelos de linguagem, esse processo é dividido entre a leitura e interpretação do prompt de entrada (prefill) e a geração contínua da resposta palavra por palavra (decode).
O Cloud Pathways é compatível com imagens de contêiner versionadas preparadas para o JAX na versão 0.10.1 em diante. O runtime também oferece suporte ao framework PyTorch e integração direta com a biblioteca de código aberto MaxText, projetada para treinamento e inferência de modelos de grande escala.
O runtime possui disponibilidade geral (GA) no Google Kubernetes Engine para as famílias Cloud TPU v5e, TPU v5p, Trillium (TPU v6e) e Ironwood (TPU 7x).
O runtime utiliza contêineres sidecar em Python com memória compartilhada diretamente nos servidores de aceleração. Quando ocorre uma falha física em algum processador, o sistema aciona um mecanismo de snapshotting de memória e redimensiona o trabalho para N-1 slices (fatias ativas) de forma automática, mantendo o cliente orquestrador conectado sem reiniciar o treino do zero.
Crédito da imagem: Divulgação/Google
 Newsletter
Com a newsletter da SantoDigital, você estará sempre um passo à frente, pronto para elevar seu negócio com o poder da inovação digital.
 Estratégias vencedoras
 Insights do universo da tecnologia
 Soluções transformadoras